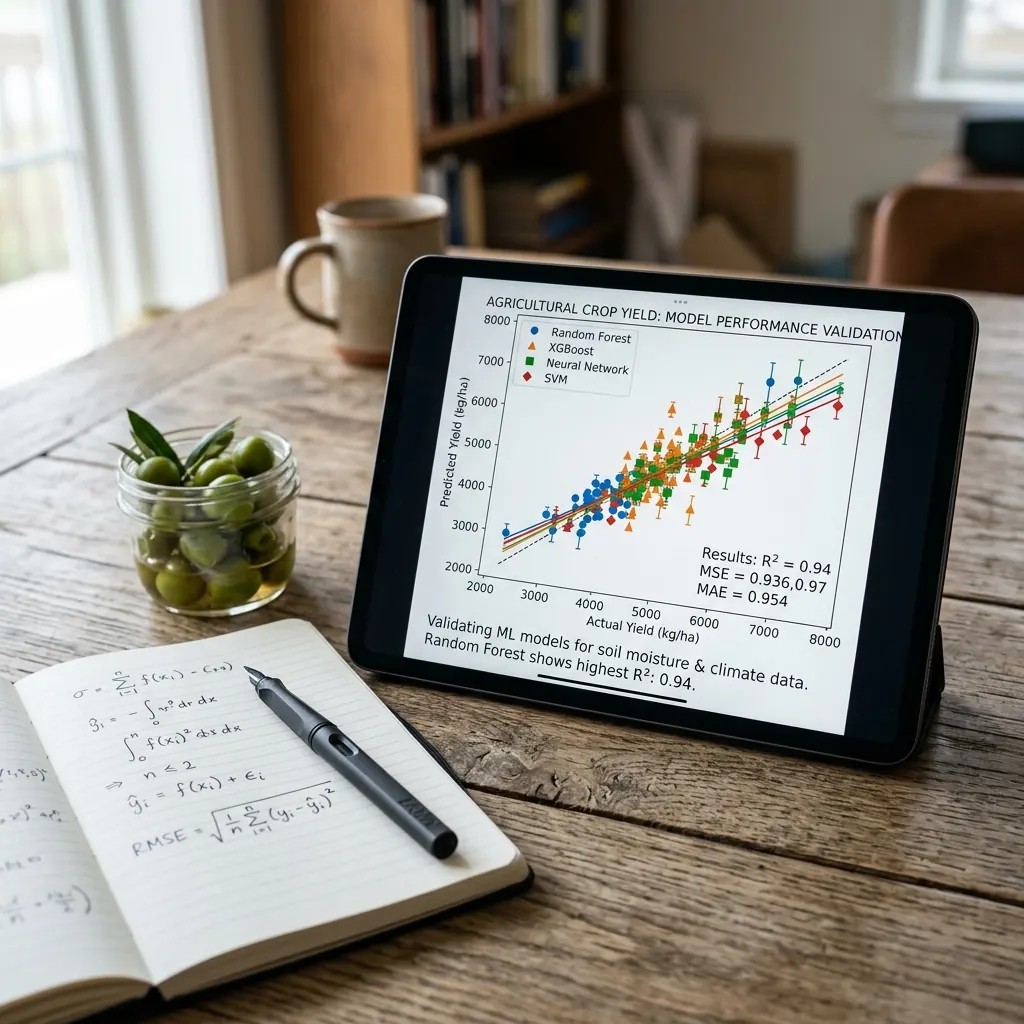
En el artículo anterior de esta serie contamos cómo el agua de invierno, el calor de junio y la inercia de la cosecha pasada se combinan para explicar la cosecha española. Una nota al pie decía que las cifras de R² presentadas allí eran ajustes simples sobre la serie completa, no validación cruzada honesta, y que la diferencia importaba más de lo que parecía. Esta es esa diferencia, y resulta que es la conversación más incómoda que se puede tener con el sector del aforo.
Dos hechos conviven desde hace quince años. Primero, los aforos oficiales —Junta de Andalucía, MAPA, COI— se equivocan año tras año en cifras enormes. La 22/23 se aforó en torno a 1 Mt en septiembre y cerró en 666 kt; la 18/19 se aforó conservadora y cerró en 1.790 kt. Errores del 30-40 % no son raros. Segundo, la literatura académica reporta modelos con R²=0,89 y R²=0,82 desde hace décadas. Si los modelos científicos predicen tan bien, ¿por qué los aforos van tan mal?
La respuesta no es agronómica, es metodológica. Los modelos publicados se evalúan en su mayoría sin validación temporal estricta. Y cuando los evalúas como un aforo real funcionaría —entrenar con el pasado y predecir el futuro—, los R² caen. La pregunta entonces es: ¿hasta dónde caen, y cuál es el techo honesto?
Hicimos el ejercicio entero. Climatología nacional 25 años, todas las variables hidrológicas y térmicas relevantes, embalses, persistencia interanual, drought index, satélite donde la serie aguanta. Modelos lineales y no lineales, validados con leave-one-out. El resultado tiene tres conclusiones, y ninguna es la que yo esperaba al empezar.
Lo que dice la literatura
Hay tres referencias canónicas en predicción de cosecha del olivar mediterráneo. Conviene tenerlas a mano antes de hablar de validación.
Galán et al. (2008). Modeling Olive Crop Yield in Andalusia, Spain. Quizá el paper más citado del campo. Modelo lineal multivariable con polen aéreo prepeak, lluvia primaveral y temperaturas estivales sobre tres provincias andaluzas (Jaén, Córdoba, Granada), serie 1990s-2000s. Reporta R²=0,89. Validación: regresión sobre la serie completa, sin LOO-CV ni reserva de años para test.
Aguilera et al. (2019). A new aerobiological indicator to optimize the prediction of the olive crop yield. Refina el indicador de polen añadiendo “días con concentración ≥400 grains/m³” y vuelve a reportar R²=0,89 en olivar intensivo del sur de España. Misma escuela, misma metodología.
Castillejo-González et al. (PLOS One, 2024). Improving early prediction of crop yield in Spanish olive groves using satellite imagery and machine learning. Modelo SVM con Sentinel-2 + clima + variables agronómicas sobre olivar de Jaén. Reporta R²>0,82. Aquí sí hay k-fold cross-validation, pero aleatoria, no temporal.
Las tres referencias coinciden: R² altos —muy altos comparados con el R²=0,40-0,55 que la regresión lineal sobre clima alcanza con los mismos datos a escala nacional anual—. La pregunta es cómo se han evaluado.
La diferencia entre evaluar y predecir
Cuando un investigador construye un modelo y reporta R²=0,89, está diciendo una de tres cosas distintas, y conviene saber cuál:
- R² in-sample: ajusta sobre todos los datos disponibles y mide cómo de bien ajusta los mismos datos. Es lo que da por defecto la regresión lineal. Casi siempre infla.
- R² con k-fold cross-validation aleatoria: divide en bloques al azar, entrena en k-1 y predice el restante. En datos temporales esto filtra información del futuro al pasado y también infla.
- R² out-of-sample temporal (LOO-CV o time-series split): entrena solo con datos previos a una fecha y predice los posteriores. Es lo que un modelo real haría cuando se usa para aforar el año que viene.
La diferencia entre el primero y el tercero puede ser de más de 30 puntos de R². No es opinión: está documentada en literatura metodológica reciente. Un trabajo en Cross-Validation Strategy Impacts the Performance and Interpretation of Machine Learning Models (AMS Journals, 2023) demuestra que el R² estimado con k-fold aleatorio puede ser más del doble que el R² real cuando el modelo se aplica a años no vistos. Y un trabajo de Precision Agriculture (Springer, 2024) titulado On crop yield modelling, predicting, and forecasting and addressing the common issues in published studies documenta que la mayoría de modelos de cosecha publicados en agricultura se entrenan y validan sobre la misma temporada, lo que produce sobreestimaciones sustanciales para decisiones operativas como aforos.
Para problemas con muestra pequeña como el aforo nacional anual —tenemos n=25 años de datos comparables, no más—, esa diferencia es la diferencia entre un titular y la realidad operativa.
El resto es para quien tiene clave
El planteamiento es abierto. Los resultados, las figuras y el examen completo los compartimos con las cooperativas, almazaras y equipos de investigación con los que trabajamos.
¿No tienes clave? Pídenosla
¿Quieres ver predicciones validadas con LOO-CV honesta y track record auditado en lugar de R² inflados? Olearia Intelligence publica sus aforos con metodología transparente y un sistema de seguimiento de aciertos por campaña. Solicita una demo.
 Comercial o envasador
 Olearia Intelligence El mercado del aceite en una pantalla: precios oficiales, clima de las zonas productoras y comercio mundial. Precios oficiales europeos Satélite de las regiones productoras Comercio de 220 países Ver Intelligence

